

100万トークンの文脈が標準仕様になった2026年、次の壁は「探す」側に立っていた。Prefrontal AIとETHチューリヒのLSA(Latent Sparse Attention)は1000万トークンのprefillでGLM-5.3-Flashの単一注意層を22.7倍、Qwen3.8-27Bを72.4倍に短縮し、精度は主要タスクで基線の95%信頼区間内に留めた。
なぜ索引器が時間の98%を占めるのか
スパースアテンションの発想は、各queryが全履歴を見ず関連の深い少数のkeyだけを見ることだ。前提は「モデルが本当に必要なkeyはごく一部だ」という検証で、論文の付録が裏付ける。128kトークンのQwen3.8-27Bで、本当に最も関連する512個のkey(全体の約0.8%)だけを見せるとRULERで98%の精度が保てた。
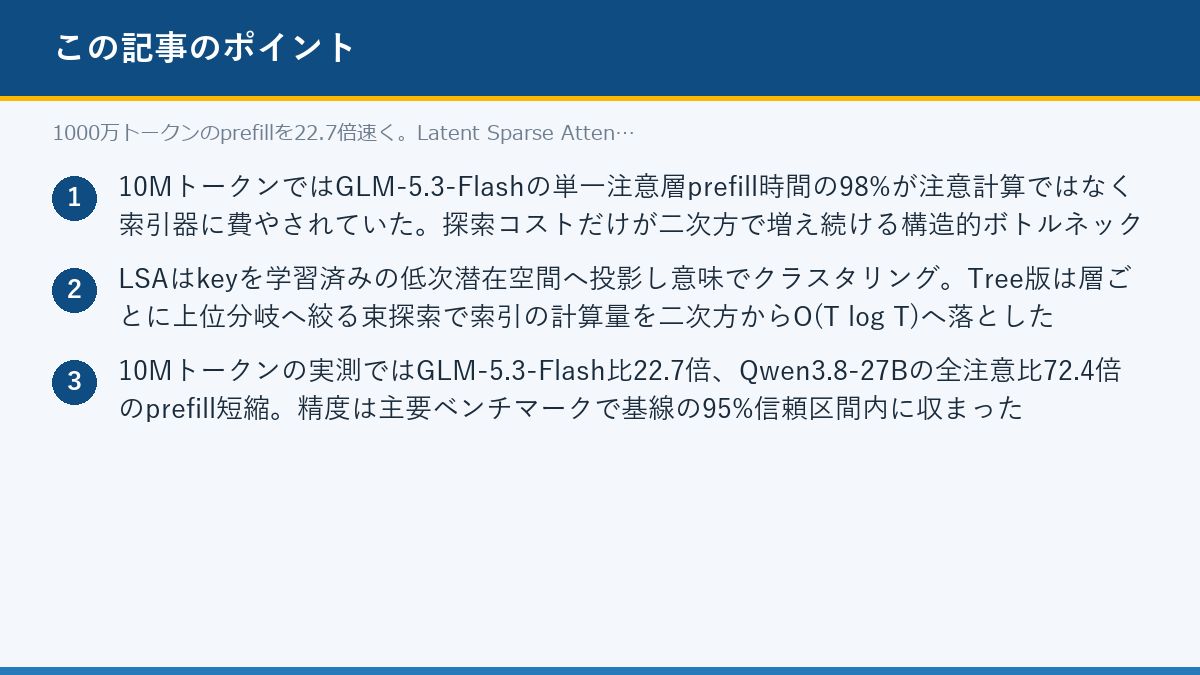
だがここに逆説が隠れる。512個を選ぶには、索引器が全keyに点数を付けねばならない。各社の方式は次元圧縮やkeyの統合で索引器を軽くしてきたが、定数項を割るだけで仕事量は文脈長に比例し、prefillは二次方のままだった。計測では10MトークンのGLM-5.3-Flash単一全局注意層で、prefill時間の98%が索引器に費やされていた。索引をゼロにできればさらに58倍速くなる。
位置でなく意味で束ねる「桶」
LSAの解法は、索引器にkeyを一つずつ見させず「集団」を見させることだ。keyを学習した低次の潜在空間へ投影し、意味の近いものをWard法で「桶」にまとめる。各桶は中心ベクトルと索引表だけを持つ。queryは桶の中心に点数を付け、選ばれた桶を展開してk個のkeyを集める。既存のブロック方式が位置で括るのに対し、LSAは内容で括り、散らばった同一主題のkeyも同じ桶に入る。
さらにTree版は桶を階層木に再編し、queryは頂点から各層で高得点の分岐だけを残す束探索で下る。中心ベクトルはO(log T)個で済み、索引のprefill計算量は二次方からO(T log T)へ落ちる。これが「subquadratic」の由来だ。
二つの導入経路と1000万トークンの成績
| 10Mトークンでの計測 | 対象 | 結果 |
|---|---|---|
| 単一注意層prefillの短縮 | GLM-5.3-Flash | 22.7倍 |
| 単一注意層prefillの短縮 | Qwen3.8-27B(全注意) | 72.4倍 |
| decodeの短縮 | GLM-5.3-Flash / Qwen3.8-27B | 4.6倍 / 42.5倍 |
| TTFT(SGLang) | GLM-5.3-Flash | 約7.5分 → 約3.4分 |
| TTFT(SGLang) | Qwen3.8-27B | 約76分 → 約8分 |
| 索引のVRAM(各層) | D-LSA / GLM原生 / ブロック方式 | 246 / 331 / 642 MiB |
精度面ではMMLU-Pro、GPQA-Diamond、LongBench v2のいずれでも基線の95%信頼区間内だった。RULERでは1M以内で全注意との差5点以内、10Mでは63.9対59.9と逆転した。実arXiv論文に架空の研究系譜を埋め込む新ベンチマークPaperTrailでも29.1対19.8と上回った。
導入経路は二つ。既存モデルへの後付けD-LSAは全パラメーターを凍結したまま、層ごとの投影行列2個だけを蒸留で足す。蒸留は3.52億トークンで、予熱だけで21億トークンを使うDSAより小さい。もう一つのN-LSAは事前訓練から原生でLSAを使い、次トークン予測損失だけで訓練する。約5億パラメーターの混合モデルの検証損失1.085は全注意と一致し、同予算のPISAは1.100だった。
よくある質問
Q. 既存のモデルにLSAを足すには再訓練が必要か。
D-LSAなら不要だ。蒸留は3.52億トークンで済み、主成分方向を使う完全無訓練版も精度が近い。
Q. 加速比は文脈が短い場合にも伸びるのか。
伸びにくい。512kでは2.1倍、1Mで3.5倍と、文脈が長いほど加速比が拡大する。
Q. 精度の劣化はどの程度か。
知識・推論・長文タスクで基線の95%信頼区間内に収まり、10MのRULERでは逆に全注意を上回った。
編集部の見解
「少なく見る」競争が一段落し、「見るべきものをどう探すか」が次の主戦場になった。数日単位のエージェント作業では、TTFTが8分か3.4分かは生産性に直結する。D-LSAが凍結モデルへの後付けで済む点は試す敷居が低い。Tree版の1億トークンでの外推値(基線比90倍超)は予測値だが、索引器の計算量を監視指標に入れる時代は近い。
my-best.ai 編集部
出典:36Kr「千万トークン規模でDeepSeek式スパース注意より22倍速い」(寄稿:Synced、2026年11月17日)
あわせて読みたい
- DeepSeekがアプリに利用制限。7日間放置の長い会話は接続不可、1回の入力は約4万字まで
- 1万体のAIエージェントが88時間でナビエ・ストークスに到達。1千万ドルの計算と未請求の100万ドル
- Fable 5.2は「ぎざぎざのAGI」。教授の一言から自生した204節・8.75万語の規則集
本日の36Kr AI版の記事を日本語で整理したものです。最新記事の一覧から他のニュースも読めます。
最新のAI情報をメールで受け取る
新着のAIツール比較・ランキング・ニュースを、まとめてお届けします。
ご登録後、確認メールをお送りします。配信停止はいつでも可能です。